


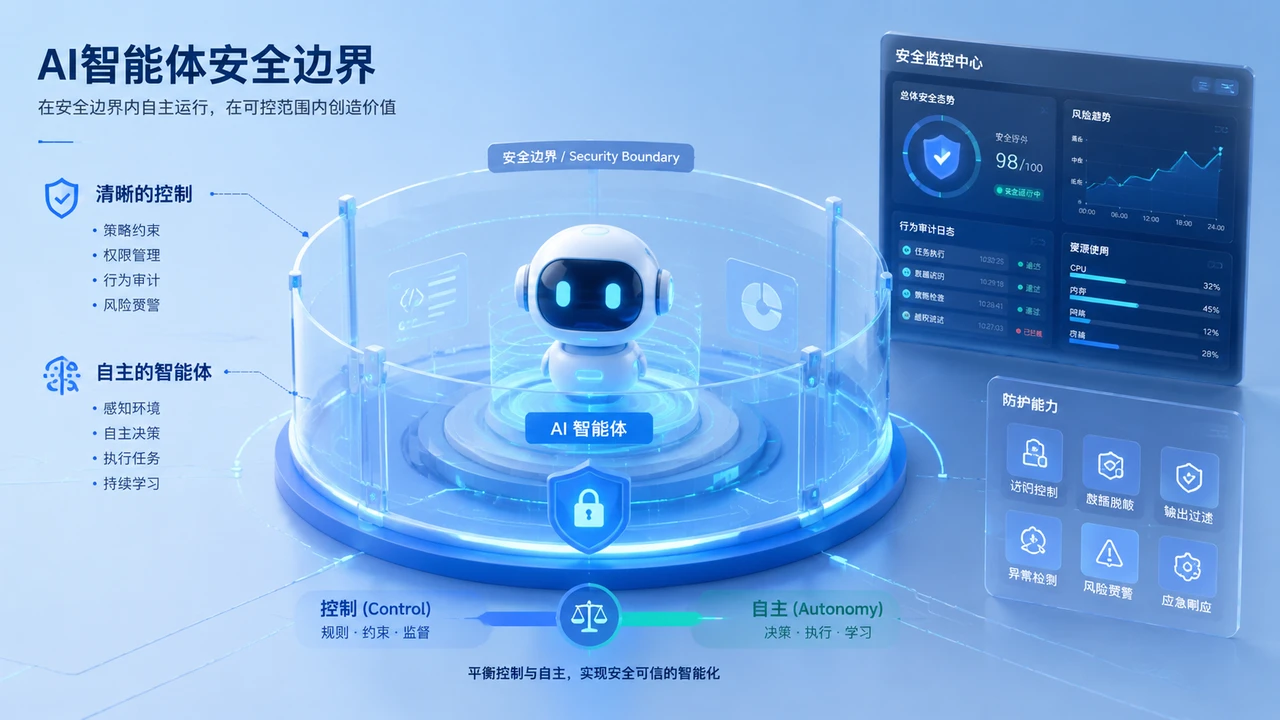
当人工智能从单纯的对话工具转向能够自主规划、调用工具并完成复杂任务的智能体,安全治理的焦点自然从“输出是否合规”转向“行为是否可控”。这一转变让治理边界从内容层面延伸到工具调用、访问权限和执行过程本身。技术管理者与行业观察者需要建立一套清晰的判断框架,来区分已知风险信号与仍需持续评估的领域,避免因单一案例推导出行业普遍结论。
智能体自主执行的核心在于它具备感知环境、记忆规划、决策执行和工具调用能力。这与大模型时代生成内容不同,后者主要风险集中在输出偏差、幻觉或偏见。而智能体一旦能直接操作文件、执行命令或联动业务系统,攻击面就从“回答是否正确”变成了“会不会越权行事、引发连锁反应”。搜索中明确指出,这要求构建“入口干净、过程可控、执行受限”的全链路防护体系,覆盖网络、应用、数据、供应链、运营和评测等六个维度,形成六维一体的治理架构。
从输出内容到工具调用,治理关注点最直接的延伸是权限边界控制。不同场景下,智能体的自主性需要严格分级管理。中国发布的《智能体应用与创新发展实施意见》明确了三阶权限体系:第一阶是纯人工决策,智能体仅提供建议,所有涉及外部系统的操作必须由人类完成;第二阶是用户审批授权,部分操作可自主执行,但敏感动作如支付、合同签署或数据删除必须等待明确批准;第三阶则是预设边界内的完全自主执行,同时要求持续记录决策日志并提供审计接口。这种分级不是一刀切,而是根据任务风险程度动态匹配控制强度,既能释放智能体的生产力,又不会让高风险操作失控。
权限控制只是起点,真正有效的边界还需通过隔离测试和过程监测来保障。智能体在执行复杂任务时,往往会跨多个系统或工具调用,攻击者可能利用提示注入、恶意技能或网关绕过等手段实现远程控制。有效的治理实践包括在受控环境中对智能体进行隔离测试,模拟各种攻击链,验证其是否会突破预设边界。同时,过程监测机制必须实时跟踪智能体的决策路径和工具调用记录,一旦发现异常行为能及时触发人工介入或停止执行。这两者的关系是:隔离测试提供前置验证,过程监测提供动态监督,而人工介入则作为最后一道防线,在完全自主模式下保留必要的人类 oversight 能力。
目前,已出现的一些风险信号包括跨层级攻击链导致的错误操作、隐私泄露或恶意指令执行,这些在2026年智能体落地加速的背景下已被观察到。360AI安全研究院等报告也强调,企业部署时必须坚守“先安全,后自治”原则,明确身份认证、工具调用、数据访问等六大核心问题。蚂蚁集团开源的SingGuard系列安全模型,就是为智能体套上“紧箍咒”的典型实践,通过针对自主执行场景的安全护栏模型实现早期干预。
然而,仍需评估的问题远不止已出现的信号。例如,智能体在多智能体协同或长周期执行中可能产生动态变异的决策路径,攻击链风险从单点扩展到网络传导,传统的事前审查方式难以完全覆盖。这些新风险的演进速度远超现有治理框架的更新速度,企业需要在可信边界内寻找“能用”与“可用”的平衡点。Gartner预测到2026年底40%的企业将集成任务型AI代理,这意味着大规模部署前,治理框架必须从“内容合规”转向“行为约束全生命周期”,而非依赖单一案例就下结论。
一套判断智能体风险边界的观察框架可简化为以下几个维度:第一,评估智能体执行任务的权限边界是否严格匹配三阶分级;第二,检查是否存在隔离测试和过程监测机制,能有效拦截提示注入等已知攻击向量;第三,明确人工介入点在何时介入何种决策,避免完全自主模式下责任模糊;第四,持续跟踪仍需评估的新风险点,如行动失控的潜在传播路径或数据可管性不足。技术管理者可据此为智能体设计治理方案,同时行业观察者也可通过这些标准,审视各组织在从“会说话”向“会办事”跃迁过程中的真实进展。
智能体安全治理的本质,是在促进技术进步与风险防范之间找到动态平衡。它提醒我们,技术边界从来不是固定不变的,而是需要持续迭代和多方参与才能维持。未来,随着治理体系从基础层到生态层的逐步完善,普通读者也能通过这些观察框架,更清晰地理解AI如何在安全框架内真正“替人做事”,而非取代人。
评论列表 (0条):
加载更多评论 Loading...