


过去几年里,衡量一个智算中心是否先进,几乎只看一个指标:堆了多少加速卡,峰值算力有多高。但这套逻辑正在失效。当国产十万卡超算集群开始落地、当最前沿模型的参数规模迈向万亿级,行业里有经验的人越来越清楚一件事——真正决定算力能不能释放出来的,已经不是卡的数量,而是整套系统能不能把这些卡高效地喂饱、散热、连起来并稳定跑下去。算力基建的竞争重心,正在从"规模扩张"悄悄移向"效能优化"。
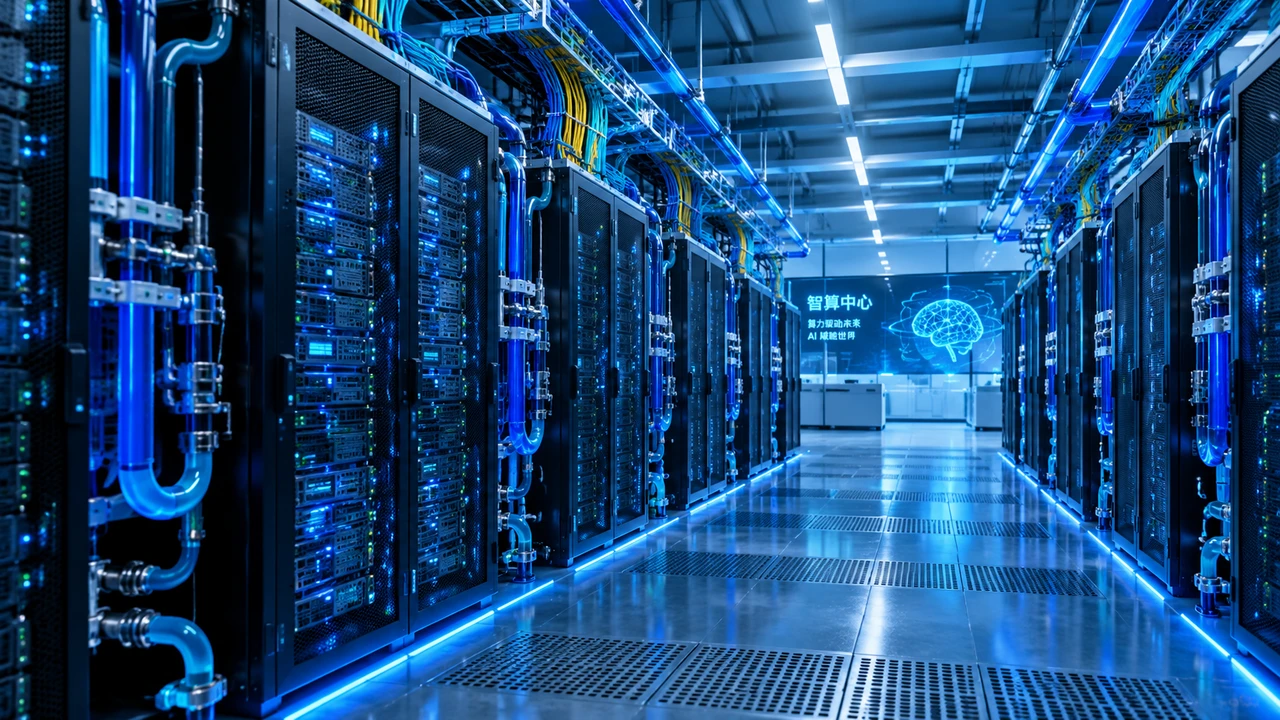
这个转折对芯片选型、数据中心设计乃至 AI 应用的成本结构都会产生连锁影响。对投资决策者和行业从业者来说,看懂这条转型路径,比盲目追逐"更大集群"更有价值。
规模扩张撞上了物理天花板
单纯扩规模之所以越来越难,不是因为钱不够,而是物理约束开始集中显现。
最直接的瓶颈是散热。当集群从千卡、万卡走向十万卡,芯片的功率密度大幅抬升,传统风冷和冷板方案逐步逼近物理上限。高温带来的降频和稳定性下降,会让理论算力在长时间训练中大打折扣——账面上算力很大,实际跑起来却在不断"缩水"。换句话说,散热不再是机房的配套问题,而是直接决定高算力芯片能否持续满负荷运行的前置条件。
功耗同样是硬约束。随着单机柜功耗向兆瓦级迈进,供电容量、机房占地、碳排指标都被绑在一起考量。有资料指出,在未来的高密度机柜里,仅输入输出(I/O)环节的功耗占比就可能达到四到五成,如果不能把这部分能耗压下去,机柜根本无法有效散热和供电。这意味着"再多塞几台机器"这种粗放做法已经走不通。
还有一层容易被忽视的瓶颈,是互联与调度。在万卡以下,很多问题可以靠堆带宽、靠人工调优暂时掩盖;但到了十万卡级别,参数同步、梯度聚合、检查点写入和推理请求分发会形成大规模并行通信,网络拥塞、尾延迟和故障恢复能力直接决定算力利用率。规模越大,系统里任何一个薄弱环节都会被放大成整体效率的拖累。
叠加上芯片供应本身的压力,单靠数量扩张的边际收益正在快速递减。行业被迫把注意力转向一个更务实的问题:同样一批芯片,怎么才能产出更多有效算力。
效能优化的几条技术主线
效能优化不是单点突破,而是沿着散热、计算架构、模型部署几条线同时推进,彼此还高度耦合。
第一条主线是液冷从"可选优化"变成"基础设施底座"。以近期落地的国产十万卡超算为例,它把计算卡、主板等部件直接浸入绝缘冷却液,利用受热沸腾的相变过程快速带走热量,再通过闭环循环完成换热。相比传统风冷,这种浸没式相变方案的散热密度显著提升,可以压缩机房占地,整机能耗降低约四成,集群电能使用效率(PUE)可低至 1.04。这组数字真正的意义不在于好看,而在于高密度部署下的持续温控不再是局部问题,而是牵动总体拥有成本、供电容量、机房利用率和碳排的系统问题。头部云厂商把液冷作为新建大型智算中心的标配要求,正是基于这个判断。
第二条主线是异构计算与开放互联。过去互联领域存在明显的私有生态优势,但随着多种开放互联标准的出现,架构规划者在未来会拥有更具性价比的异构集群选择空间。在横向扩展(Scale-out)层面,以太网凭借在拥塞控制和重传机制上的改进,正重新成为支撑超大规模集群的事实选择;在光互联层面,从可插拔方案向共封装方案的跨越,核心目的之一就是压低那部分居高不下的 I/O 功耗。这些变化共同指向一个方向:让不同来源、不同形态的算力资源能被更灵活、更低能耗地"捏"在一起协同工作。
第三条主线是大模型的压缩与高效部署。模型规模确实还在往万亿级参数走,但真正影响成本的是运行方式。混合专家(MoE)这类稀疏计算路线的思路,是即便总参数达到数万亿,每次实际激活的参数仍保持在相对可控的区间,从而在模型容量和推理成本之间取得平衡。与此同时,算力消耗的结构也在位移——在生产级模型的全生命周期里,推理加上基于强化学习的后期训练,已经占到相当大比例的总成本。这说明算力需求正从"一次性的大规模预训练"转向"高效在线推理"和"持续微调优化"。谁能把推理环节的单位成本压下来,谁就掌握了应用落地的主动权。
把这三条线放在一起看会发现,它们解决的其实是同一个问题的不同侧面:如何在既定的功耗和芯片约束下,让每一瓦电、每一颗芯片产出尽可能多的有效算力。
头部企业的布局正在换挡
这种转型在头部企业的动作里体现得很清楚,策略重心明显从"抢规模"转向"抢系统能力"。
一个信号是建设标准的抬高。字节、阿里、腾讯等企业在持续加码智算中心投入、扩容异构集群的同时,把液冷散热从高端机房的优化项变成了新建集群的强制配套。这背后是对能耗管控和硬件散热双重约束的提前应对——与其建成后再改造,不如在设计初期就把高密机柜、液冷管路、漏液监测、材料兼容性和运维规范一并纳入。
另一个信号是从"单卡竞争"转向"全链路协同"。当竞争焦点从单颗加速卡转向集群系统工程,网络、散热、存储和调度能力开始成为决定成败的关键。能够实现从加速芯片、整机计算、存储到高速网络的协同设计,意味着集群不只要"算得快",还要"传得稳、存得进、调得动"。这也是通信设备、光模块、交换芯片和云网服务等环节的新机会窗口。
更宏观的一层,是布局逻辑与能源、区域的深度绑定。在"东数西算"的框架下,算力需求密集型集群与绿色低碳型集群被分别布置在不同枢纽,液冷技术、绿电直供与源网荷储一体化被纳入同一套设计。到 2025 年底,我国智能算力规模已超过 1590 EFLOPS,这个体量本身就决定了,继续靠粗放扩张难以为继,算电协同和效能优化成为必然选择。
值得留意的是,这条路径也伴随着现实挑战:高速互联、超大规模调度的稳定性仍有差距,软硬件兼容适配复杂,异构硬件与软件框架的生态碎片化问题突出。效能优化不是一句口号,它恰恰是在这些工程难题里一点点抠出来的。
给决策者的几点判断
对正在做基建投资或技术选型的人来说,这轮转型提供了几个可以直接拿来用的判断依据。
- 评估一个集群,不要只看峰值算力和卡的数量,更要看有效算力利用率、PUE、全链路协同能力和长时间运行的稳定性。
- 散热和供电方案应在建设初期就纳入系统设计,而不是事后改造;液冷等高密度温控能力正在从加分项变成准入门槛。
- 关注算力需求向推理和持续优化环节的位移,优先投资能降低单位推理成本的架构,而不是一味追求更大的训练集群。
- 在异构与开放互联趋势下,保留灵活的集群选型空间,避免被单一生态锁死。
说到底,AI 算力基建这一轮的拐点,考验的不再是谁的集群更大,而是谁能在功耗、散热、芯片供应的多重约束下,把系统的每一个环节都优化到位。规模曾经是门槛,如今效能才是真正拉开差距的地方。谁先完成从"堆规模"到"抠效能"的思维切换,谁就更有可能在下一阶段的竞争里站稳脚跟。
评论列表 (0条):
加载更多评论 Loading...